二叉树遍历:前序、中序与后序的递归写法
二叉树的前序、中序和后序遍历,名字看起来像三套不同的算法,真正写成递归代码后却只差一行的位置:什么时候访问根结点。
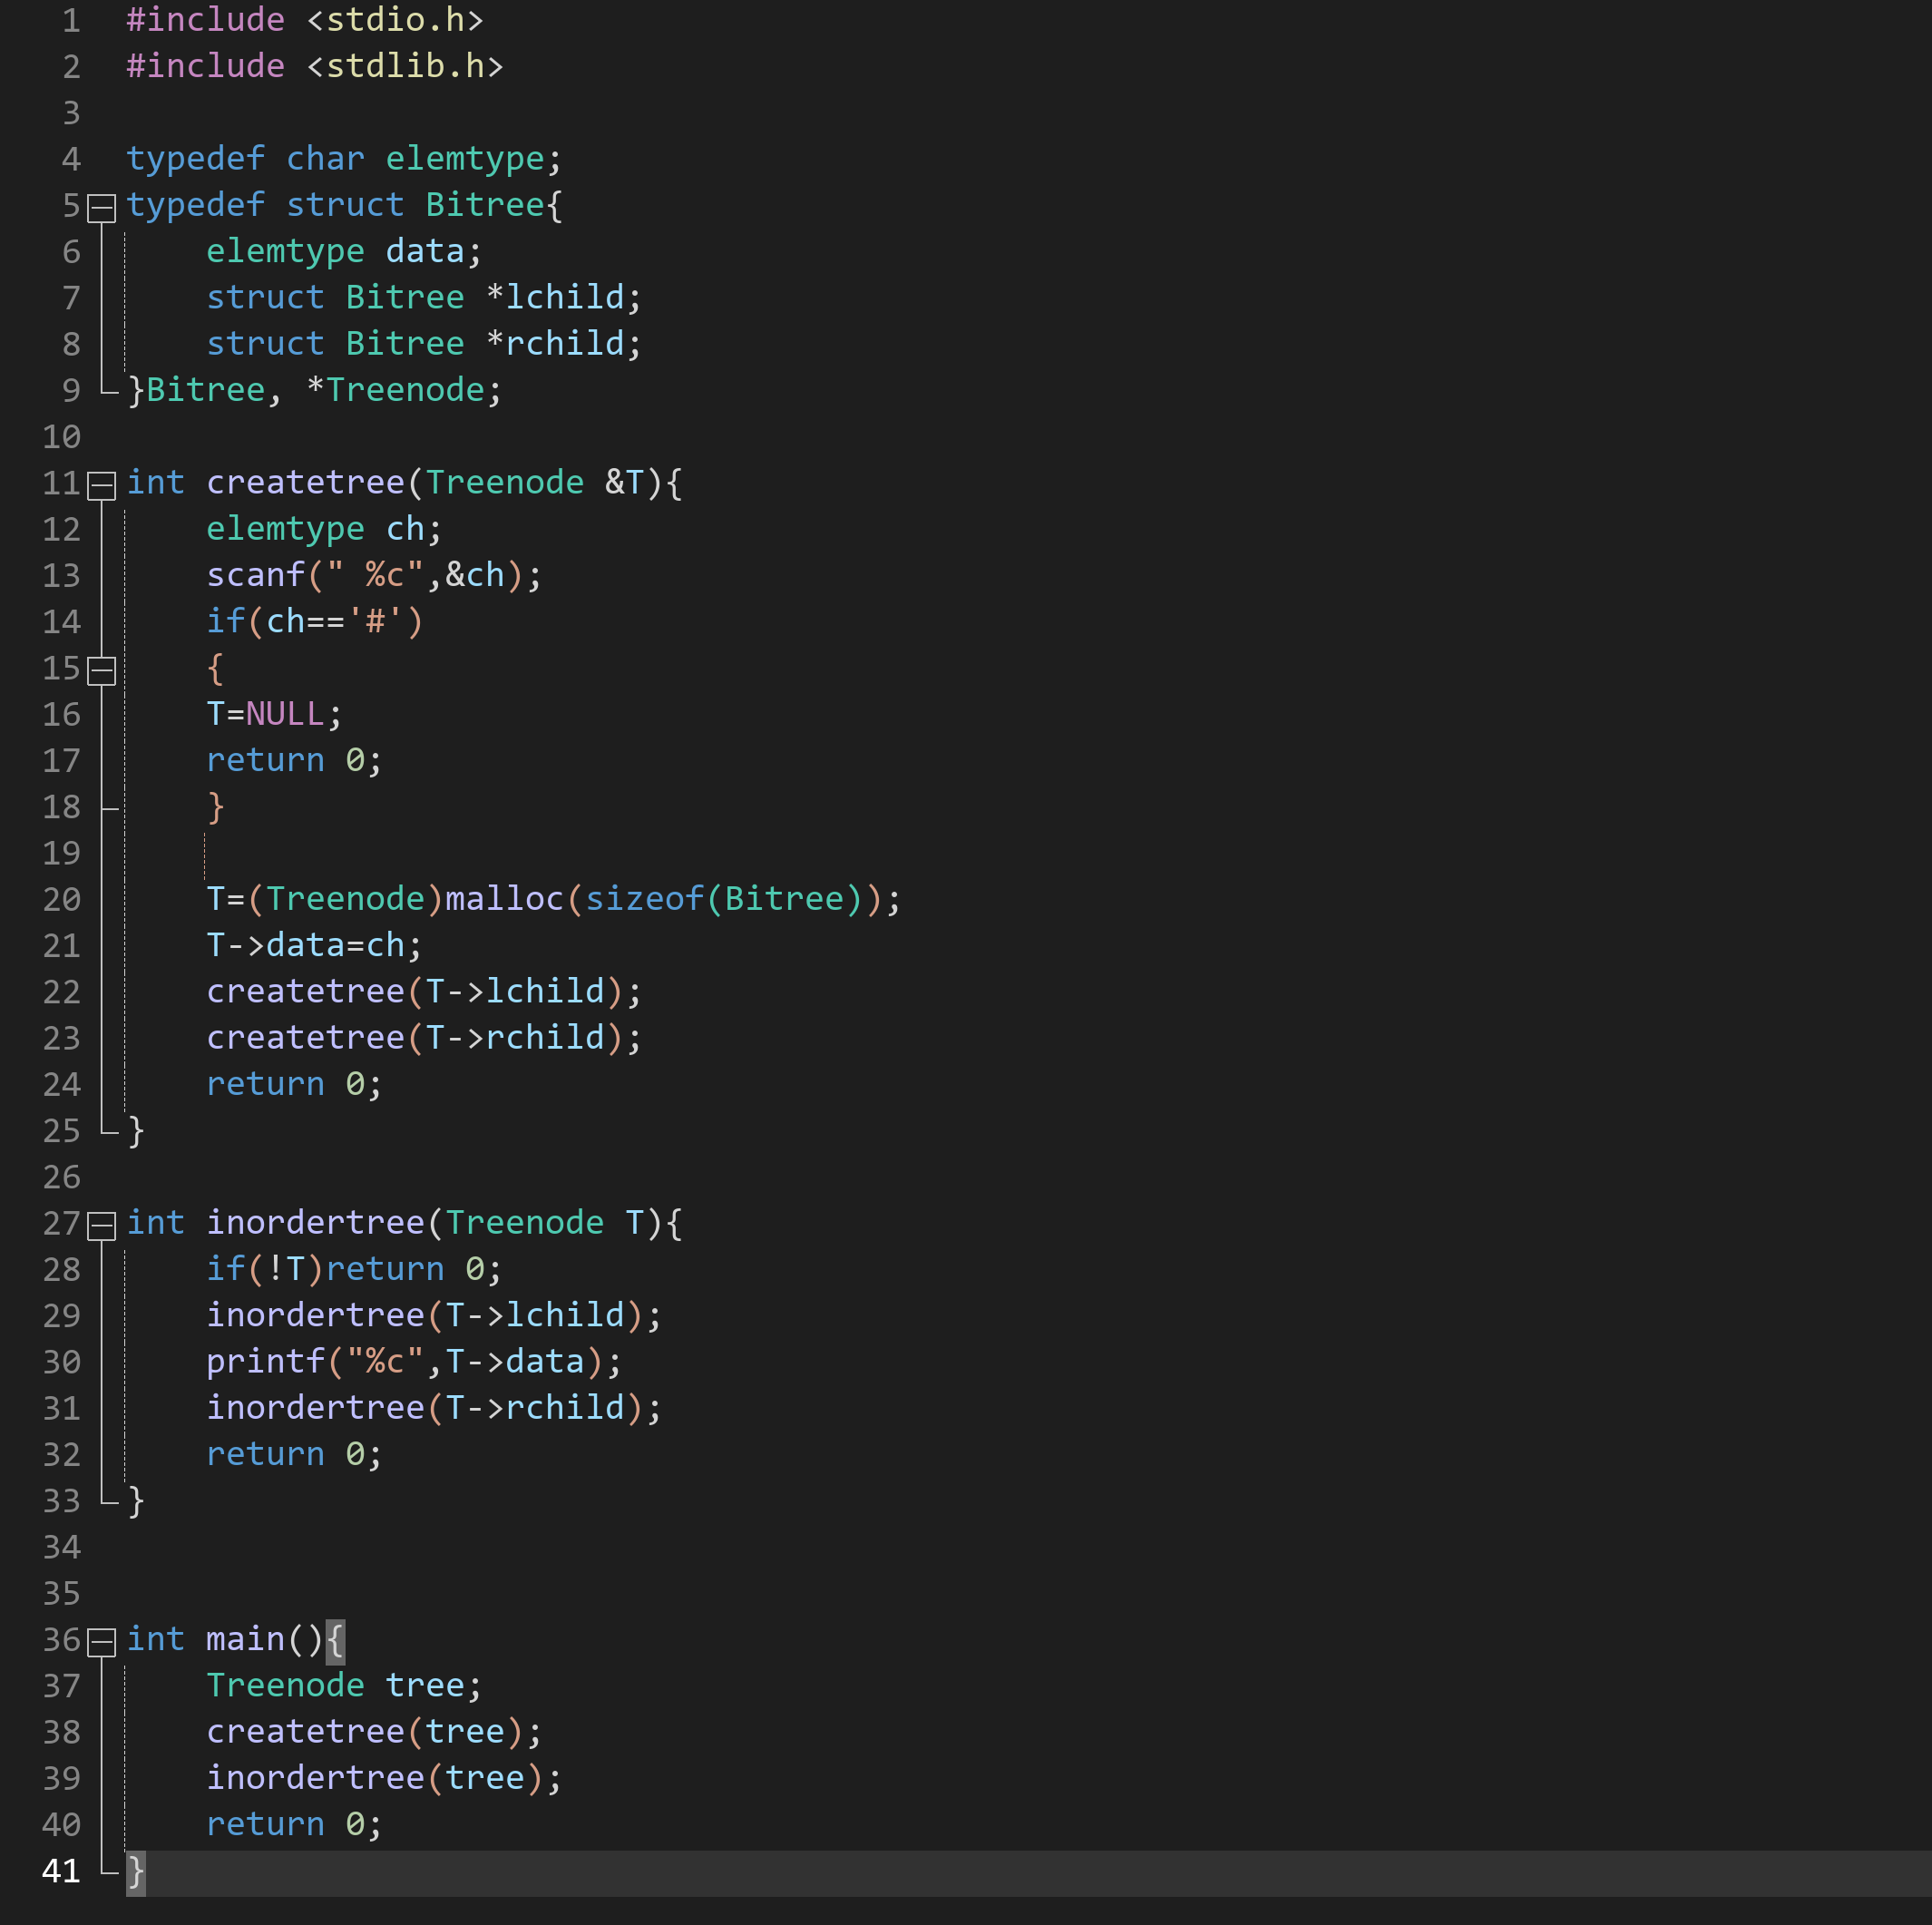
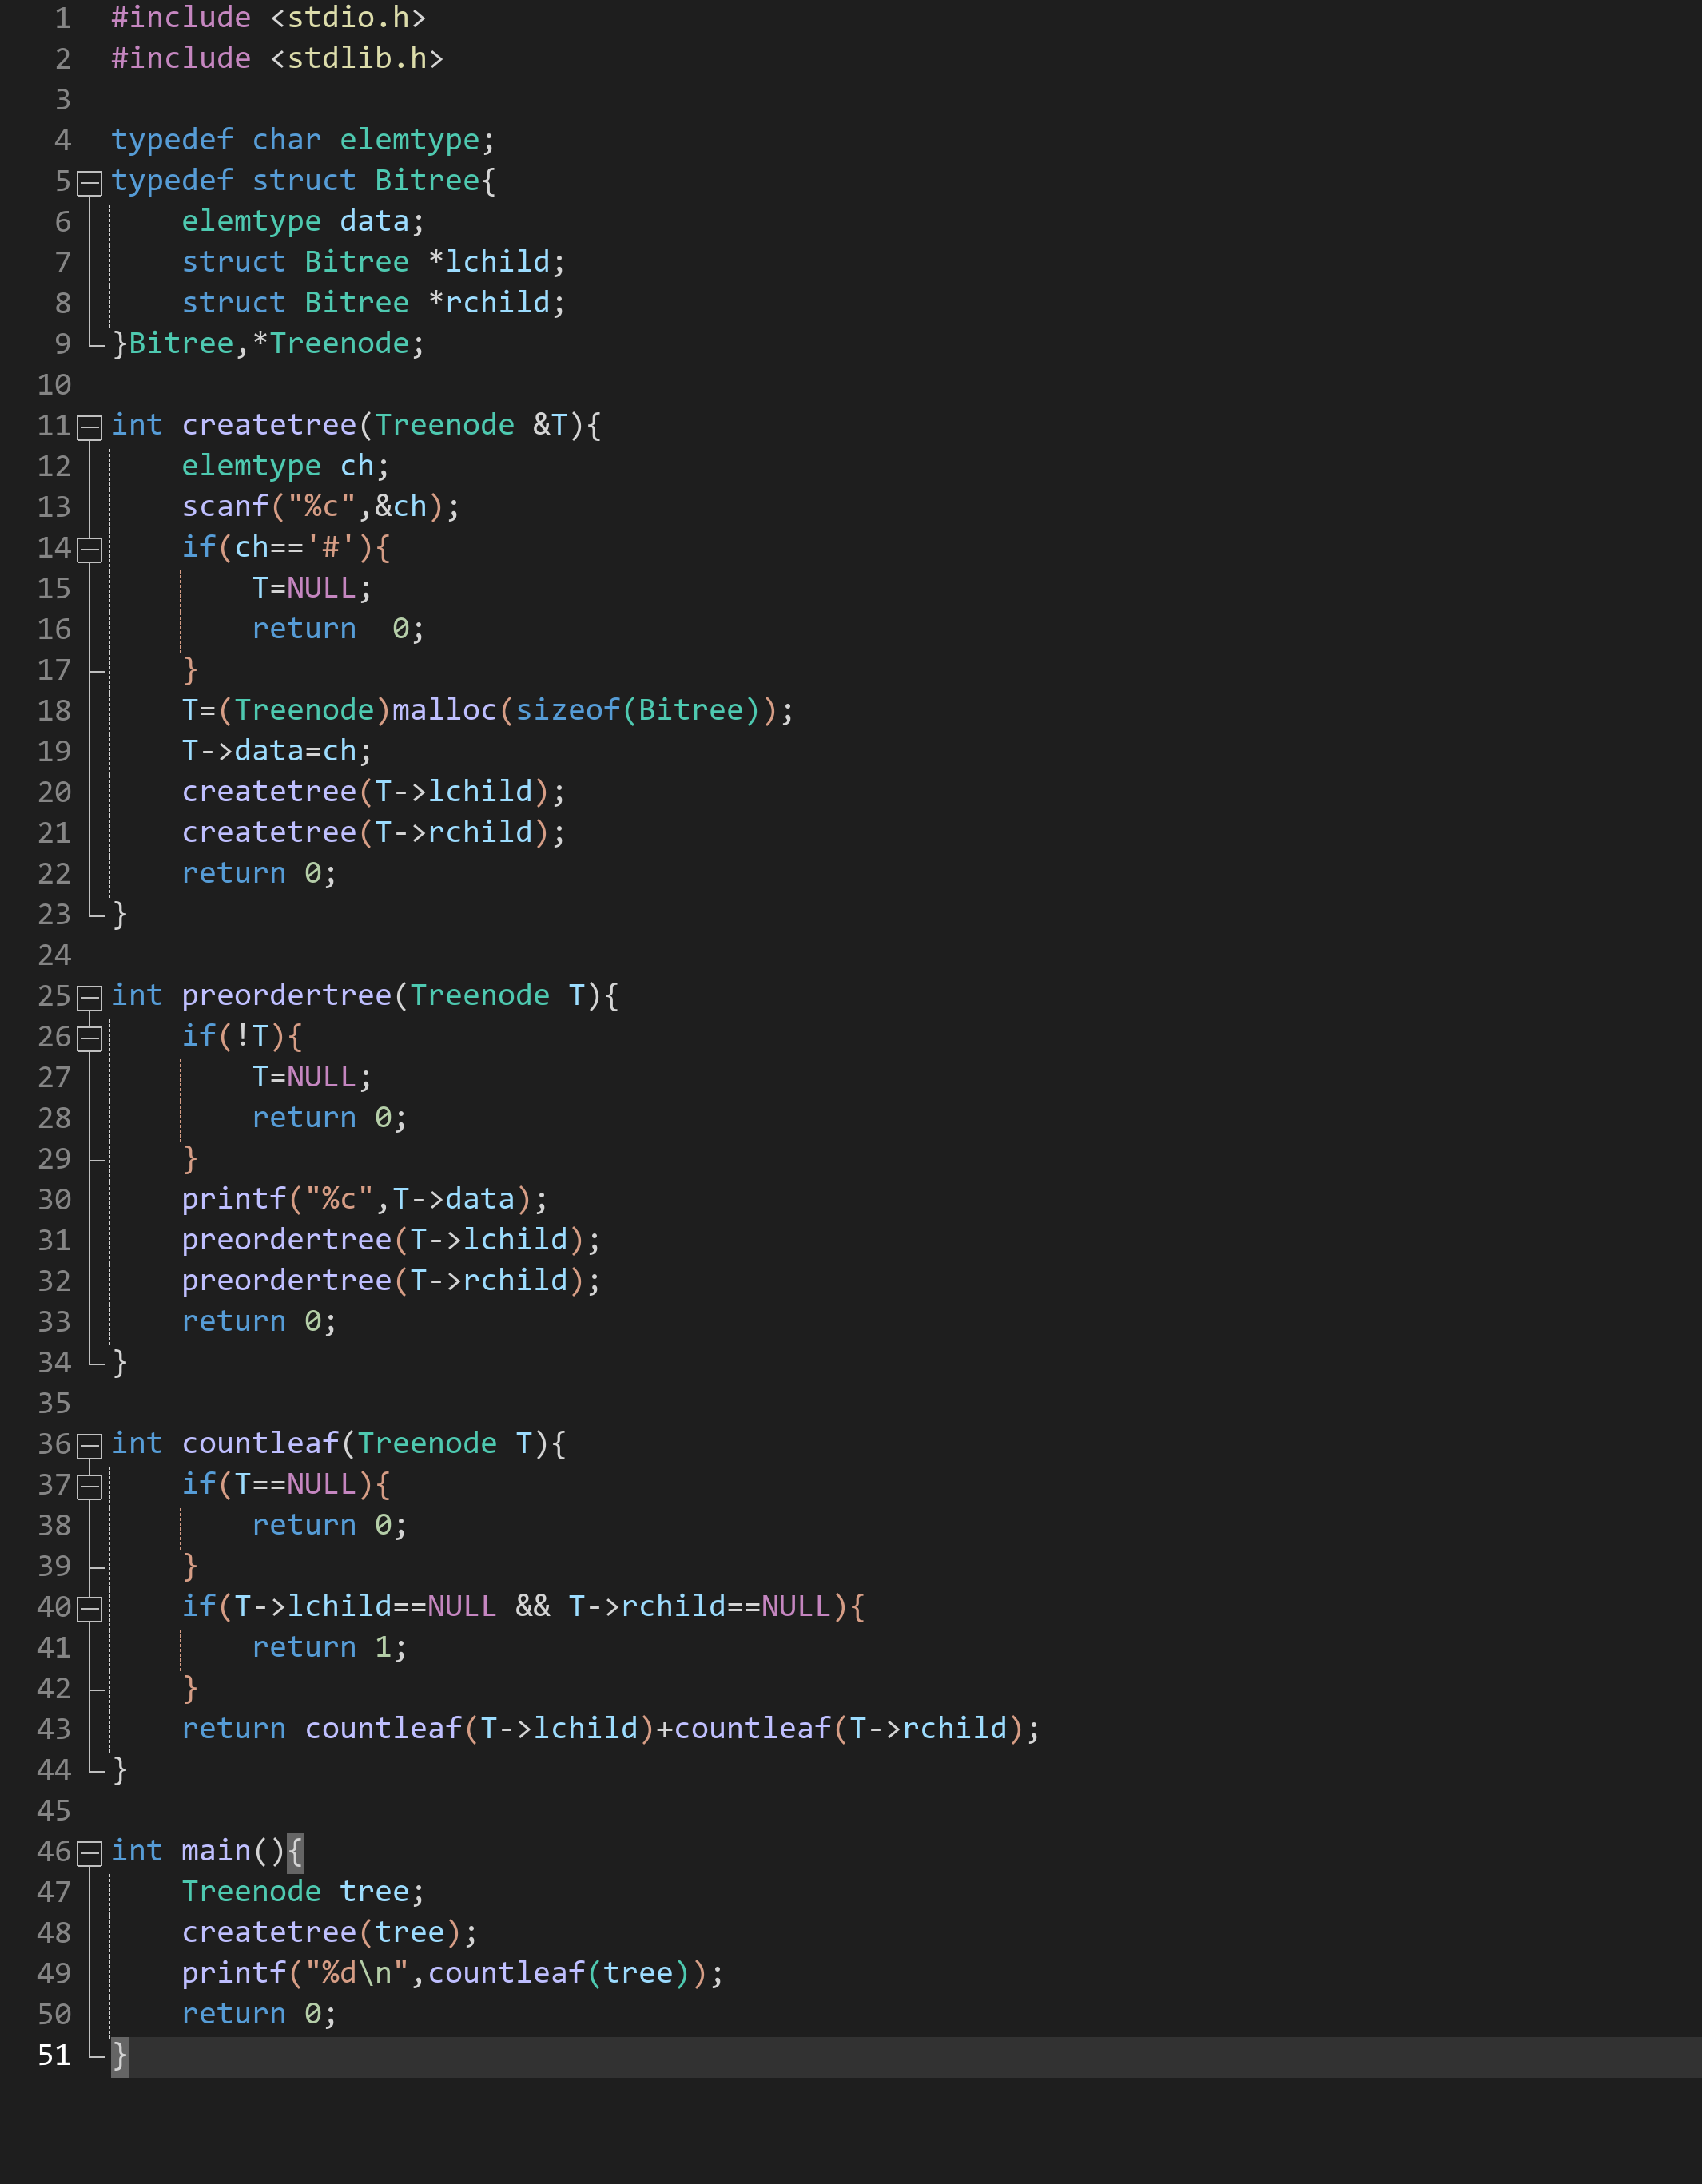
这篇文章结合 tree1.cpp 和 tree2.cpp 两份练习代码,从建树开始,把三种深度优先遍历放到同一棵树上比较。两份源码中已经实现了前序遍历和中序遍历,后序遍历则可以沿用完全相同的递归框架补出来。老师写的代码太乱了,如下是我综合了一些教材上的代码和老师的代码,自己古法编程写出来的。tree1.cpp和tree2.cpp分别对应上下两张图。
一、先看结点定义:每个结点有两个孩子
两份代码使用了相同的二叉链表结构:
typedef char elemtype;

typedef struct Bitree {
    elemtype data;
    struct Bitree *lchild;
    struct Bitree *rchild;
} Bitree, *Treenode;
每个结点由三部分组成:
| 成员 | 含义 |
|---|---|
data | 当前结点保存的字符 |
lchild | 指向左孩子 |
rchild | 指向右孩子 |
Bitree 表示一个结点的结构体类型,Treenode 则是 Bitree * 的别名。因此下面两种声明是等价的:
Bitree *tree;
Treenode tree;
树为空时,根指针是 NULL;某个孩子不存在时,对应的 lchild 或 rchild 也是 NULL。
二、先序建树:输入里为什么要有 #
两份源码都通过递归创建二叉树:
int createtree(Treenode &T) {
    elemtype ch;
    scanf(" %c", &ch);

    if (ch == '#') {
        T = NULL;
        return 0;
    }

    T = (Treenode)malloc(sizeof(Bitree));
    T->data = ch;
    createtree(T->lchild);
    createtree(T->rchild);
    return 0;
}
这个函数读取字符的顺序是:
- 读取当前结点
- 递归创建左子树
- 递归创建右子树
也就是按照“根、左、右”的顺序建树。输入字符 # 表示这里没有结点,递归到此结束。如果不记录空结点,只给出普通的前序序列,很多不同形状的树会得到同一串字符,程序无法唯一还原原树。
例如输入:
ABD##E##CF###会创建下面这棵树:
        A
       / \
      B   C
     / \  /
    D  E F
按建树过程拆开看:
| 输入片段 | 含义 |
|---|---|
A | 创建根结点 A |
B | A 的左孩子是 B |
D## | B 的左孩子是叶子 D,D 的左右孩子均为空 |
E## | B 的右孩子是叶子 E |
C | A 的右孩子是 C |
F## | C 的左孩子是叶子 F |
# | C 的右孩子为空 |
这里的参数必须写成 Treenode &T。递归创建孩子时,需要修改调用者保存的指针;如果只按值传递 Treenode T,函数修改的只是指针副本,创建出的结点无法接回原树。
三、三种遍历,本质只差访问根的位置
遍历一棵非空二叉树时,总要完成三件事:
- 访问根结点
- 遍历左子树
- 遍历右子树
为了保持定义统一,三种遍历都规定左子树先于右子树。所谓“前、中、后”,指的是根结点相对于左右子树的访问位置。
| 遍历方式 | 访问顺序 | 记忆方法 |
|---|---|---|
| 前序遍历 | 根 → 左 → 右 | 根在前 |
| 中序遍历 | 左 → 根 → 右 | 根在中 |
| 后序遍历 | 左 → 右 → 根 | 根在后 |
对应到递归代码,唯一需要移动的就是 printf:
// 前序:先输出根
printf("%c", T->data);
preordertree(T->lchild);
preordertree(T->rchild);

// 中序:在左右子树之间输出根
inordertree(T->lchild);
printf("%c", T->data);
inordertree(T->rchild);

// 后序:最后输出根
postordertree(T->lchild);
postordertree(T->rchild);
printf("%c", T->data);
判断遍历顺序时,不要盯着函数名看,直接看访问根结点的语句放在哪里。
四、前序遍历:根、左、右
tree2.cpp 中的前序遍历写法是:
int preordertree(Treenode T) {
    if (!T) {
        return 0;
    }

    printf("%c", T->data);
    preordertree(T->lchild);
    preordertree(T->rchild);
    return 0;
}
函数进入结点后立刻输出数据,所以根结点最先被访问。对示例树执行前序遍历:
A → B → D → E → C → F最终输出:
ABDECF前序遍历的特点是能先看到每棵子树的根。它常用于复制一棵树、输出目录结构,以及配合空结点标记序列化二叉树。前面的 createtree 正是按照前序顺序读取数据,所以“带 # 的前序序列”既能保存结点数据,也能保存树的形状。
原函数在空树分支里还有一句 T = NULL:
if (!T) {
    T = NULL;
    return 0;
}这里的参数是按值传递,T 本来就已经是 NULL,再次赋值不会影响调用者,也没有实际作用,直接 return 0 即可。
五、中序遍历:左、根、右
tree1.cpp 实现的是中序遍历:
int inordertree(Treenode T) {
    if (!T) {
        return 0;
    }

    inordertree(T->lchild);
    printf("%c", T->data);
    inordertree(T->rchild);
    return 0;
}
程序先把左子树完整遍历完,再访问根,最后遍历右子树。对示例树执行中序遍历:
D → B → E → A → F → C最终输出:
DBEAFC中序遍历有一个很重要的用途:对二叉搜索树进行中序遍历,会按从小到大的顺序得到所有关键字。 这是由二叉搜索树“左子树小于根,右子树大于根”的性质决定的;普通二叉树不具备这个排序效果。
六、后序遍历:左、右、根
两份源码没有写后序遍历,但只需把访问根结点的代码移到最后:
int postordertree(Treenode T) {
    if (!T) {
        return 0;
    }

    postordertree(T->lchild);
    postordertree(T->rchild);
    printf("%c", T->data);
    return 0;
}
对示例树执行后序遍历:
D → E → B → F → C → A最终输出:
DEBFCA后序遍历总是在处理父结点之前处理完两个孩子,因此特别适合“先处理子树,再处理整棵树”的任务。例如释放二叉树时,必须先释放左右子树,最后才能释放根结点:
void destroytree(Treenode &T) {
    if (!T) {
        return;
    }

    destroytree(T->lchild);
    destroytree(T->rchild);
    free(T);
    T = NULL;
}
如果先 free(T),后面就不能再通过 T->lchild 和 T->rchild 找到孩子,因此销毁二叉树天然要使用后序思路。
七、把三种结果放在一起比较
仍然使用输入 ABD##E##CF###:
| 遍历方式 | 递归顺序 | 输出结果 |
|---|---|---|
| 前序 | 根 → 左 → 右 | ABDECF |
| 中序 | 左 → 根 → 右 | DBEAFC |
| 后序 | 左 → 右 → 根 | DEBFCA |
可以用两个规律快速检查结果:
- 前序遍历的第一个结点一定是整棵树的根,因此第一个字符是
A - 后序遍历的最后一个结点一定是整棵树的根,因此最后一个字符是
A
中序遍历里,根 A 会把序列分成左右两部分:左边 DBE 全部来自左子树,右边 FC 全部来自右子树。这个性质也是根据“前序 + 中序”或“后序 + 中序”还原二叉树的基础。
八、tree2.cpp 的叶子结点统计
tree2.cpp 虽然定义了 preordertree,但 main 实际调用的是 countleaf:
int countleaf(Treenode T) {
    if (T == NULL) {
        return 0;
    }

    if (T->lchild == NULL && T->rchild == NULL) {
        return 1;
    }

    return countleaf(T->lchild) + countleaf(T->rchild);
}
它把问题分成三种情况:
| 当前结点状态 | 返回值 |
|---|---|
| 空结点 | 0 |
| 左右孩子都为空,即叶子结点 | 1 |
| 非叶子结点 | 左子树叶子数 + 右子树叶子数 |
示例树中的叶子结点是 D、E、F,所以输出为:
3这个函数也体现了递归处理二叉树的通用模式:先明确空树的返回值,再明确最小问题的答案,最后把左右子树的结果组合起来。
九、一份可以直接运行的完整代码
把建树、三种遍历、叶子计数和销毁操作合并后,可以得到下面的完整程序:
#include <stdio.h>
#include <stdlib.h>

typedef char elemtype;

typedef struct Bitree {
    elemtype data;
    struct Bitree *lchild;
    struct Bitree *rchild;
} Bitree, *Treenode;

void createtree(Treenode &T) {
    elemtype ch;
    scanf(" %c", &ch);

    if (ch == '#') {
        T = NULL;
        return;
    }

    T = (Treenode)malloc(sizeof(Bitree));
    if (!T) {
        exit(EXIT_FAILURE);
    }

    T->data = ch;
    createtree(T->lchild);
    createtree(T->rchild);
}

void preordertree(Treenode T) {
    if (!T) return;

    printf("%c", T->data);
    preordertree(T->lchild);
    preordertree(T->rchild);
}

void inordertree(Treenode T) {
    if (!T) return;

    inordertree(T->lchild);
    printf("%c", T->data);
    inordertree(T->rchild);
}

void postordertree(Treenode T) {
    if (!T) return;

    postordertree(T->lchild);
    postordertree(T->rchild);
    printf("%c", T->data);
}

int countleaf(Treenode T) {
    if (!T) return 0;
    if (!T->lchild && !T->rchild) return 1;

    return countleaf(T->lchild) + countleaf(T->rchild);
}

void destroytree(Treenode &T) {
    if (!T) return;

    destroytree(T->lchild);
    destroytree(T->rchild);
    free(T);
    T = NULL;
}

int main() {
    Treenode tree;
    createtree(tree);

    printf("前序遍历:");
    preordertree(tree);

    printf("\n中序遍历:");
    inordertree(tree);

    printf("\n后序遍历:");
    postordertree(tree);

    printf("\n叶子结点数:%d\n", countleaf(tree));

    destroytree(tree);
    return 0;
}
输入:
ABD##E##CF###输出:
前序遍历:ABDECF
中序遍历:DBEAFC
后序遍历:DEBFCA
叶子结点数:3
十、复杂度:三种遍历其实完全相同
设二叉树共有 n 个结点。三种遍历都会对每个非空结点访问一次,因此时间复杂度都是:
O(n)递归调用需要使用函数调用栈,栈的最大深度等于树高 h,因此额外空间复杂度是:
O(h)树比较平衡时,高度约为 log n,空间复杂度接近 O(log n);树退化成只有左孩子或只有右孩子的链时,高度为 n,最坏空间复杂度是 O(n)。
十一、两份源码里值得注意的细节
1. scanf(" %c") 前面的空格有作用
tree1.cpp 使用:
scanf(" %c", &ch);tree2.cpp 使用:
scanf("%c", &ch);格式串中 %c 前面的空格会跳过换行、空格和制表符等空白字符。因此:
- 输入连续字符串
ABD##E##CF###时,两种写法都能工作 - 如果为了看清结构而输入
A B D # # ...,只有" %c"会自动跳过字符之间的空格 "%c"会把空格或回车本身也读成一个结点的数据
对于这类单字符建树程序,使用 scanf(" %c", &ch) 通常更稳妥。
2. 代码使用了 C++ 引用,不是纯 C
虽然源码使用 stdio.h、stdlib.h、malloc 等 C 风格接口,但参数 Treenode &T 是 C++ 的引用语法,因此文件需要按 C++ 编译,扩展名写成 .cpp 是正确的。
3. malloc 需要检查是否成功
原代码分配结点后直接写入:
T = (Treenode)malloc(sizeof(Bitree));
T->data = ch;如果内存分配失败,T 会是 NULL,继续访问 T->data 会导致程序异常。完整版本中增加了判空,并用 exit(EXIT_FAILURE) 结束程序。
4. 建树后应该释放所有结点
两份源码在程序结束前都没有主动释放树结点。短程序结束后操作系统会回收进程内存,但养成成对管理 malloc / free 的习惯更重要。销毁时要采用后序顺序:先孩子,后根。
十二、结语
前序、中序、后序遍历不需要背三份完全不同的代码。递归框架始终是“空树返回,递归处理左右子树”,真正决定遍历名称的只有根结点的访问位置:
前序:根左右
中序:左根右
后序:左右根理解这一点之后,很多二叉树问题都会变得清晰:需要先处理根再深入,就接近前序;需要在左右子树之间处理根,就接近中序;需要等待两个孩子的结果再处理根,就接近后序。countleaf、销毁二叉树乃至后面要学的树高计算,本质上都是在这个递归框架里选择合适的处理时机与返回值。